AIエージェントの「記憶」をどうするか
自作のAIアシスタント「xangi」を、毎日のように使っています。
xangiは、CodexやClaude CodeなどのAIエージェントをDiscordやWebブラウザから使えるようにするソフトです。私は日記やメモ、過去の会話、開発記録などをワークスペースに保存して、AIエージェントから参照できるようにしています。
便利なのですが、記録が増えるほど、必要なときに見つけるのが難しくなります。
そこで、ワークスペースを検索するxangi用の拡張機能「xangi-search」を作りました。
xangi-searchは、ファイルの全文検索と意味検索を組み合わせて、過去のメモや記録をローカルで探すソフトです。検索処理そのものにはLLMを使わず、検索用の索引や設定もワークスペース内に保存します。長く覚えておきたい内容を「FACT」として保存する機能もあります。
xangiなしでもWeb UIやCLIから検索できる
xangi-searchは単体のWeb UIとCLIを備えています。ブラウザで検索語を入力すると関連ファイルと該当部分が表示され、AIを起動せずローカル検索ツールとして使えます。
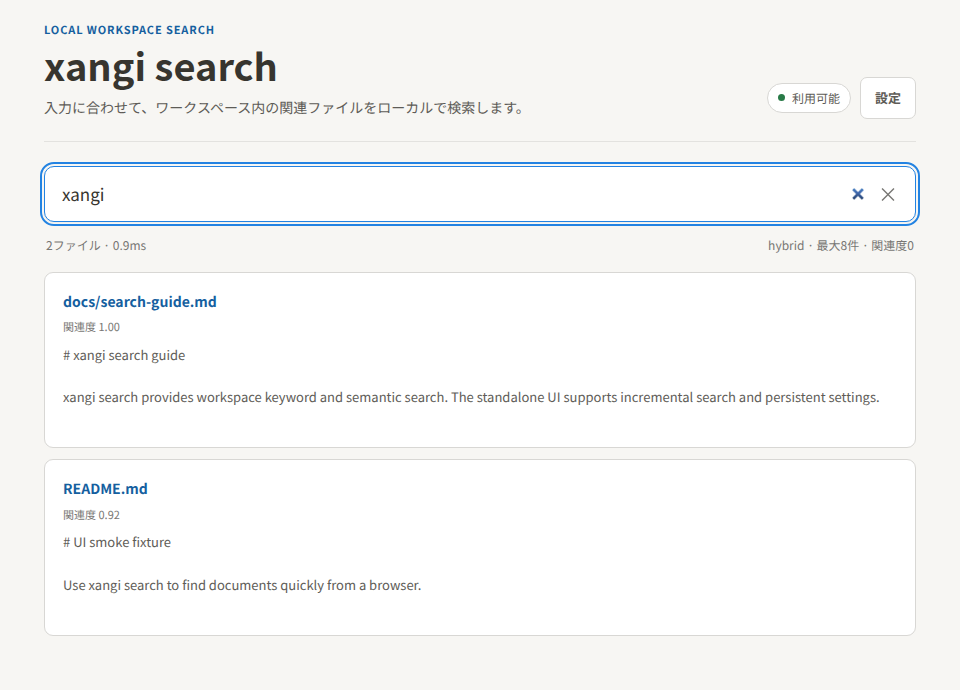
xangiへ組み込むと、AIエージェントが同じ検索機能を呼び出せます。xangiのWeb Chat、Discord、Slackから「過去の記録を探して」と会話で依頼できます。xangi-searchが各チャットへ直接接続するのではなく、xangiが検索を仲介する構成です。
『検索システム』を読んで検索を基礎から学び直した
xangi-searchを作るきっかけの一つになったのが、佐藤竜馬さんの書籍『検索システム なぜ検索システムは欲しい情報を見つけられるのか、あるいはなぜ見つけられないのか』です。

正確には、本を読んでからxangi-searchを作り始めたわけではありません。先にAIと一緒に検索機能を作って使っていたものの「検索って重要だな」と改めて思い、網羅的に検索について知りたくなり本を買いました。
私はRAGやベクトル検索については知っていましたが、キーワード検索の仕組みや評価方法といった基本は抜け落ちていました。この本は、索引語検索、ベクトル検索、生成検索から評価手法までを扱っていて、検索の全体像をつかむのによい本だと思います。
本を参考にxangi-searchを見直した結果、検索方式そのものは劇的には変わりませんでした。AIが作った最初の設計が、思ったより無難でよくできていたのです。ただ大きな変化として「性能を測る」ようになりました。それまでは、自分が使って満足できればよいという感覚で作っていました。本を読んでから、正解となるファイルを検索結果の何位に出せたか、方式を変えると回答品質や処理時間がどう変わるかを、同じ問題で比較するようになりました。
今回紹介する108セッションの実験も、その延長で生まれたものです。理論を読んで終わりではなく、自分のソフトへ持ち帰って測ってみたことで、検索についての理解がかなり深まったように感じています。
AIに全部探させると意外にトークンを使う
最初は「Codexならrgやファイル読み込みを使って、自分で必要な情報を探せるのだから、それでよいのでは?」とも思っていました。実際、小さなワークスペースなら、それでもかなりうまく動きます。
ただし、私のワークスペースには、ブログ記事、日記、ノート、ソースコード、過去の会話ログなどが大量に入っています。今回の実験用に固定したデータだけでも、10,411ファイルありました。
この中からAIエージェント自身に情報を探してもらうと、検索語を考え、rgで探し、ファイルを読み、足りなければ検索し直します。ツールを使うたびに、それまでの会話や結果を含む文脈をモデルへ再入力するため、往復が増えるほど入力トークンも膨らみます。
人間にたとえると、巨大な書庫で資料を探すたびに、それまで読んだ資料を全部机へ積み直しているようなものです。これだと効率が悪くなるのは、想像できるかと思います。
先に検索して必要な資料だけ渡す
そこで試したのが、AIエージェントを本格的に動かす前にxangi-searchで検索する方式です。実験では「preflight(事前検索)」と呼んでいます。
先にxangi-searchが質問に関係するファイルを検索して、小さな「根拠パック」を作ります。AIエージェントには、質問と一緒にこの根拠パックを渡します。情報が足りない場合だけ、追加でファイルを探します。
従来方式とpreflight方式の流れを並べると、違いは次のようになります。
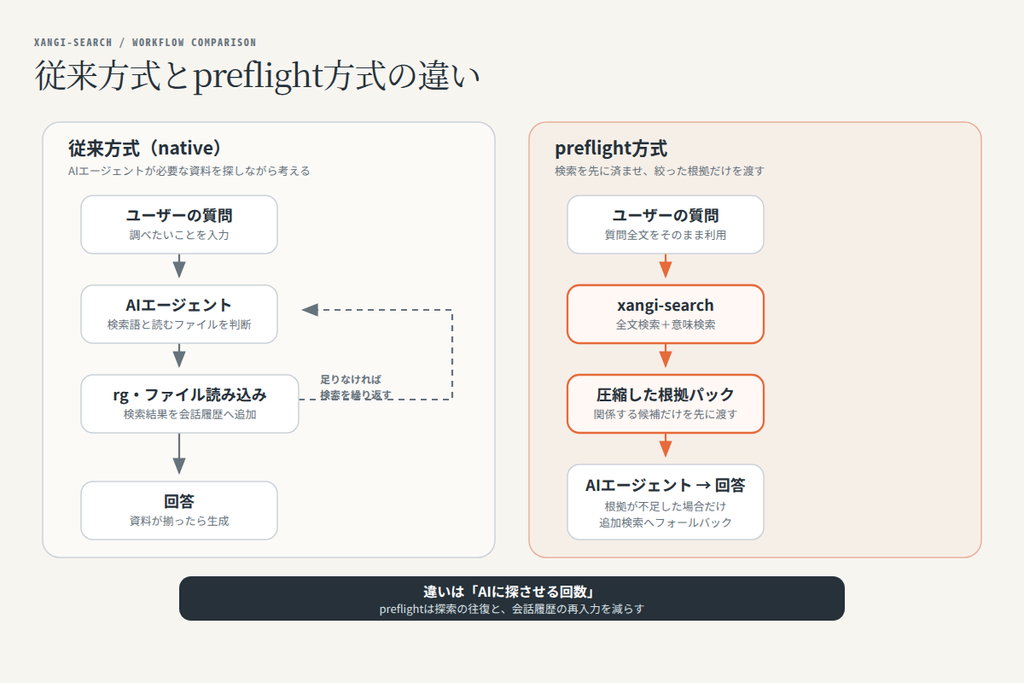
比較したのは次の3方式です。
- native:Codexが
rgやファイル読み込みを使って自力で探す - keyword preflight:全文検索で先に根拠を集める
- hybrid preflight:全文検索と意味検索を組み合わせて先に根拠を集める
keywordは検索語と一致する文章を見つけるのが得意です。hybridは、それに加えてベクトル検索を用いることで意味の近い文章を見つけることもできるようになります。固有名詞や関数名を探すならkeyword、過去の出来事や曖昧な記憶を探すならhybridが向いています。
108セッションで比較した結果
実験条件は、固定した12問を各方式で3回ずつ実行するものです。合計108セッションを、同じ10,411ファイル、同じモデル(gpt-5.6-sol、推論強度high)で比較しました。
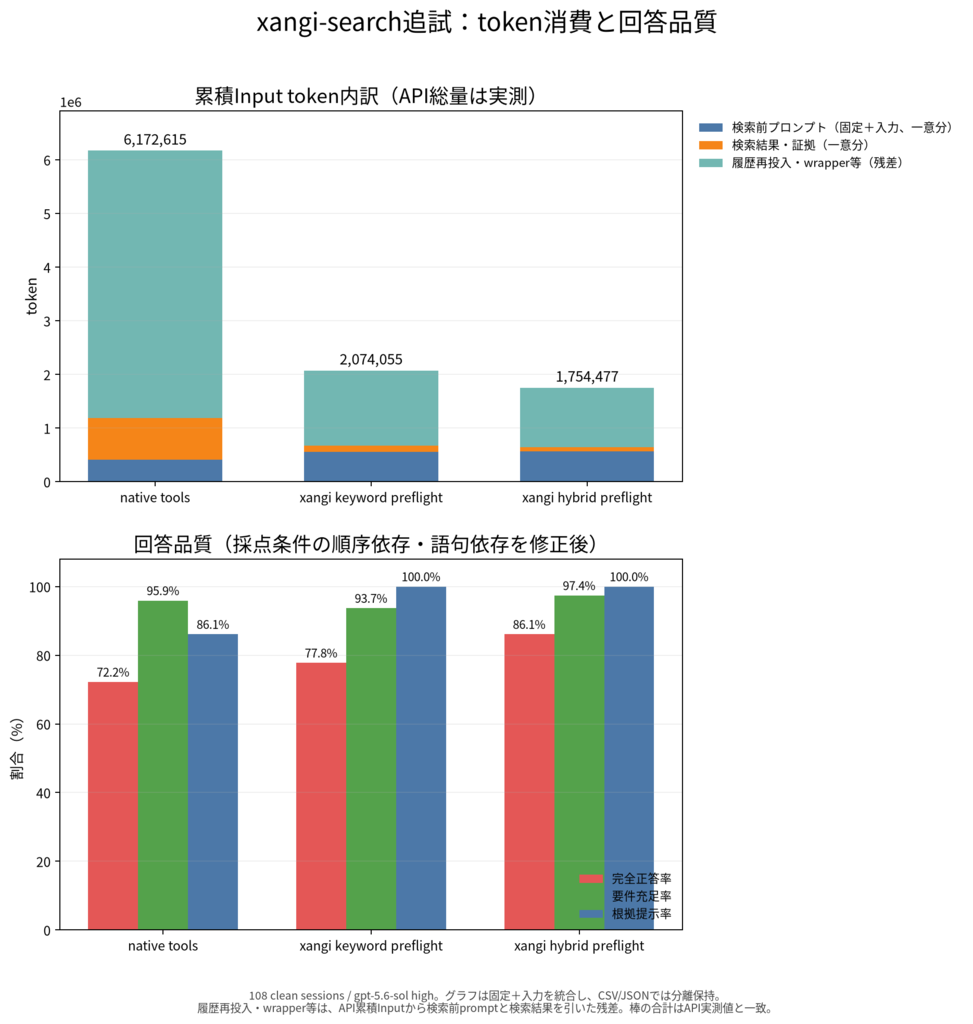
結果は以下のようになりました。
| 方式 | 入力トークン合計 | native比 | 時間中央値 | 厳密正答率 | 根拠一致率 |
|---|---|---|---|---|---|
| native | 6,172,615 | 基準 | 31.09秒 | 72.2% | 86.1% |
| keyword preflight | 2,074,055 | 66.40%減 | 13.88秒 | 77.8% | 100% |
| hybrid preflight | 1,754,477 | 71.58%減 | 12.36秒 | 86.1% | 100% |
一番よかったhybrid preflightでは、nativeと比べて入力トークンが71.58%減り、処理時間の中央値も60.23%短くなりました。ツール呼び出し回数も平均72.67%減っています。
トークンを減らしたことで回答品質が落ちていないかも確認しました。今回の問題では、厳密正答率が72.2%から86.1%へ上がり、期待した根拠ファイルとの一致率は86.1%から100%になりました。
検索でうまく情報を絞ると、安くて速いだけでなく、AIエージェントが関係のないファイルへ迷い込むことも減るようです。
数字を見るときの注意点
今回の結果は、私のワークスペースと12問の固定問題を使った実測です。どんな環境でも必ず約72%減るわけではなく、ファイル数、質問、モデルなどで結果は変わります。ただ、同じ問題を同じ条件で108セッション動かし、入力トークン、処理時間、回答品質、根拠の一致まで比較できたのは、私にとっては今後の改善を考える上で大きな手がかりになりました。
preflight方式を利用するには、xangi-search v0.2.0以降が必要です。v0.2.0でxangi-search-preflight-hookが追加され、対応するxangi v0.52.1では、AIエージェントを起動する前に圧縮した根拠候補を渡せるようになりました。xangi-search単体のWeb UIやCLIから使う通常の検索とは別の連携機能になります。
まとめ
AIエージェント用のローカル検索拡張「xangi-search」を作り、AIエージェントが自力でファイルを探す方式と、先に検索結果を渡す方式を比較したお話でした。
今回の環境では、全文検索と意味検索を組み合わせた事前検索により、入力トークンを71.58%、処理時間の中央値を60.23%削減できました。回答品質と根拠の一致率も改善しました。
AIエージェントを賢くするというと、ついモデルへ目が向きますが、モデルはChatGPTやClaudeはかなり賢くなっているので、そうなると差が出てくるのは入力するデータ(コンテキスト)であり、そのコンテキストをいかに抽出するかという検索が重要だなという当たり前のことに気づきました。
なお、この記事で書かれていることは検索の手法や事前検索のフロー含めて特に新しいことはありません。ただ、自分のデータで実際に測定してみることは重要かなと思います。もし検索に興味を持たれた方は、自分のデータで性能を測定してみることをおすすめします。
xangi-searchを作った経緯や、書籍『検索システム』を読んで考えたことは、「からあげ帝国放送局」第145回でも話しています。散歩しながら話しているので、開発中に感じていた迷いや、検索は用途によって最適な方法が変わるという話をもう少し生々しく聞きたい方はこちらもどうぞ。
