AIの利用枠を使い切りました
先週、契約しているChatGPT Proの利用枠を使い切りました。月額200ドルで、今まで使い切ることなかったのですが、先週はAIアシスタントソフトの「xangi」の開発やAIでDJ・VJするソフトを作ったりしていて見事に上限へ到達しました。
使えなくなったのは2日ほどだったのですが、これがなかなかつらかったです。以前、音声配信で自分のことを「AIジャンキー」と表現していたのですが、AIが使えなくなると本当に不安になってきて手が震えきたので、ほぼ中毒者でした。
この体験をきっかけに、トークンの節約やローカルLLMの活用を本気で考えてみました。
AI動作環境の整理
私は最近、NVIDIAのDGX SparkでQwen3.8-27B-NVFP4(以降Qwen3.8)を動かしています。かなり優秀なモデルなのでChatGPTが使えなくなったときも「ローカルLLMがあるから大丈夫」と思っていたのですが、実際に代役を任せてみると、最初は全然ダメでした。
「こんにちは」の返信に5分弱かかる始末です。到底実用できません。
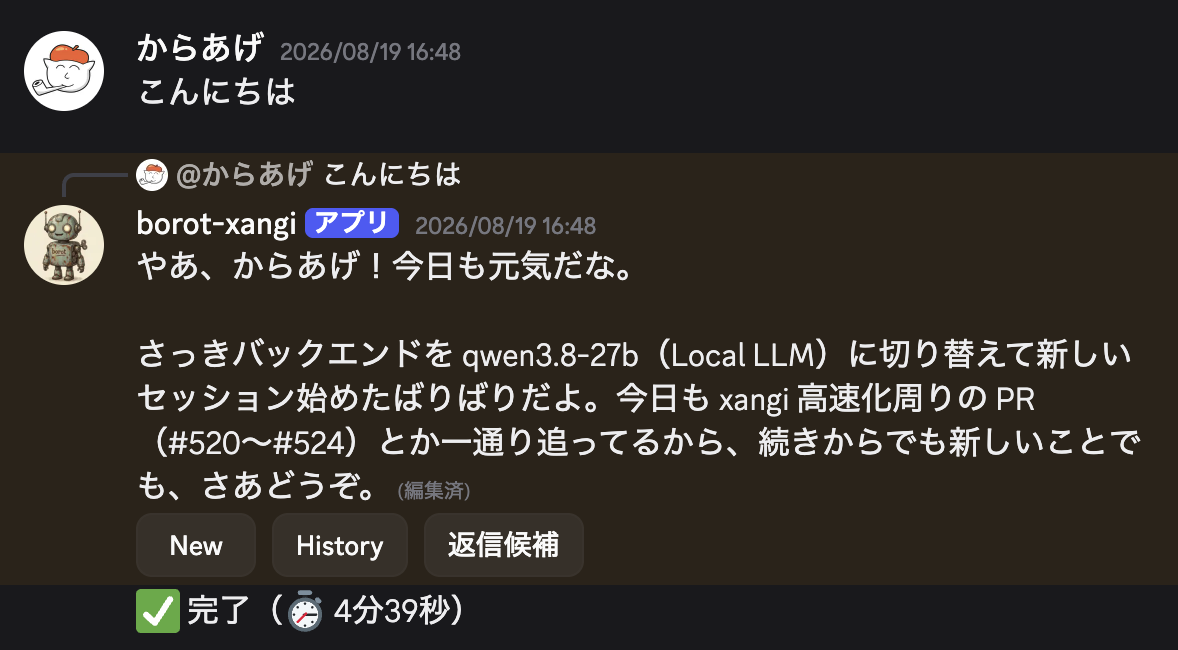
原因を調べると、モデルだけの問題でなく、AIを働かせる環境が複雑になりすぎていました。長いシステムプロンプト(AGENTS.md)、大量のツール、大量のスキル、積み上がった例外ルール。GPT-5.6 Solのような高性能なモデルは、多少散らかった環境でも空気を読んで仕事を進めてくれます。そのため、環境側の問題が表面化していなかったのです。
人間の組織でも、能力の高い人が個人技で何とかしているうちは、手順や環境の問題が隠れがちです。そこへ新しい人が入ると急に仕事が回らなくなり、初めてオンボーディングや道具の整備が必要だと気づきます。AIでも同じことが起きるのが面白いですね。
そこで、最初に渡す指示を圧縮し、使うツールを整理し、仕事の入口を分かりやすくしました。これはローカルLLMのためだけではなく、高性能なモデルの迷いを減らし、入力トークンを削減する効果もあります。
今回使ったモデルやDGX Spark上での動かし方、推論エンジンごとの実測結果は、以下の記事にまとめています。
GPT Solを上司Qwenを部下にしてみる
次に試したのが、GPT-5.6 Solを監督役にして、実際のコーディングをQwen3.8へ委譲する構成です。高性能なクラウドAIには仕事の設計と検収を任せ、時間はかかるけれど手元の電気代だけで動くローカルLLMに作業してもらいます。
いわば「AI上司とローカルLLM部下」です。
この構成を試したきっかけは、以下のtoyoshiさんの投稿です。
個人の開発はChatGPT Plus($20)でSolに監督をさせてローカルのQwen3.8(27B NVFP4+DFlash2)に実装させるというスタイルになってる。個人開発でこんな節約する必要ないんだけどなんか得した気持ちになるので選んでしまう #ローカルLLM pic.twitter.com/jyGSh7sJcs
— とよし🍅株式会社トクイテン代表 (@toyoshi) 2026年8月21日
Gitの操作等も含めてQwenに任せるのは不安があったので、GPTと組み合わせて使うのは実用的かもと思いました。
ところが最初は、むしろGPT Solのトークンが増えました。何が起きていたかというと、GPT SolがQwenに雑に仕事を丸投げしたあげく、上がってきた成果物を最初から全部読み直し、間違いを自分で修正していました。典型的なヤバマイクロマネジメント上司ですね。
このままではまずいと、作業範囲を小さく切り、変更してよいファイルを限定し、テストや画面表示などの受け入れ条件を先に決めて、上司は実装の全過程を追いかけず、最後に条件を満たしたかを確認するような形にしました。不合格なら自分で直さず、具体的な理由を添えて部下へ差し戻します。
実際の人同士の開発と似せた形です。
本当にトークンを節約できたのか
Podcastを収録した時点では、別の試行結果から「監督役のトークンを約80%削減できた」と話しました。ただし条件を十分に揃えた比較ではなく、品質への影響も未検証だったので、その後に専用の小さな開発課題を作って比較し直しました。
同じ初期状態から、ミッション管理画面を作る課題をGPT Solへ直接頼む場合と、GPT SolからQwenへ委譲する場合を比較しました。両方とも、テスト、変更ファイルの制限、デスクトップとスマートフォンでの表示、データの保存と再読み込みまで確認しています。
AIエージェントソフトとしては自作ソフトの「xangi」を使っています。最初はQwenの推論用バックエンドに「OpenCode」を使っていましたが、最終的には「xangi」独自のローカルLLM用バックエンドを使って評価しました。
比較条件、課題、独立したテスト、委譲用スキルは、以下のリポジトリで公開しています。結果を再確認したい方や、別のモデルで試したい方は参照してください。
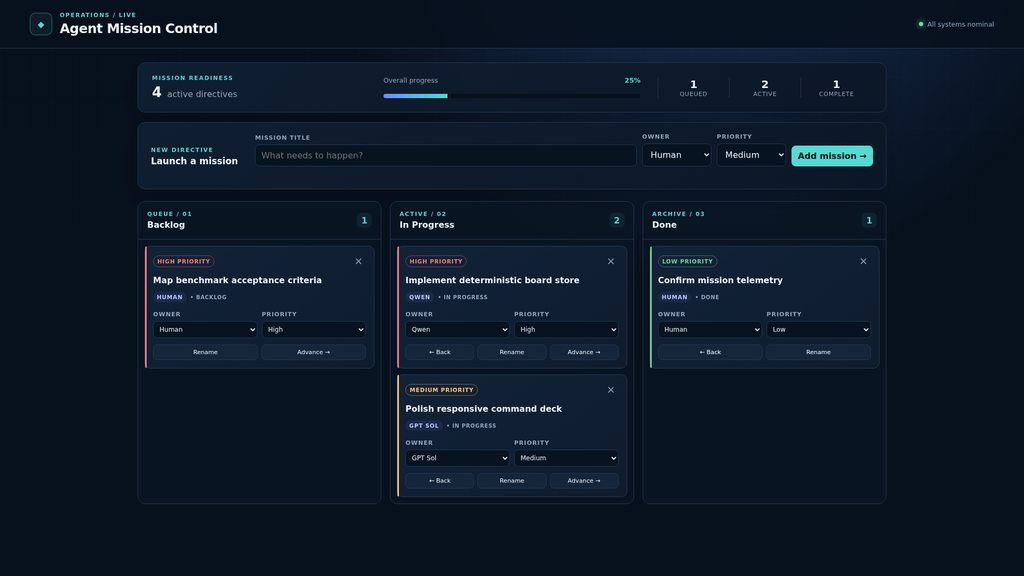
GPT Solが直接実装した「Agent Mission Control」です。ミッションの追加、担当者や優先度の変更、進捗の移動、ブラウザへの保存ができます。
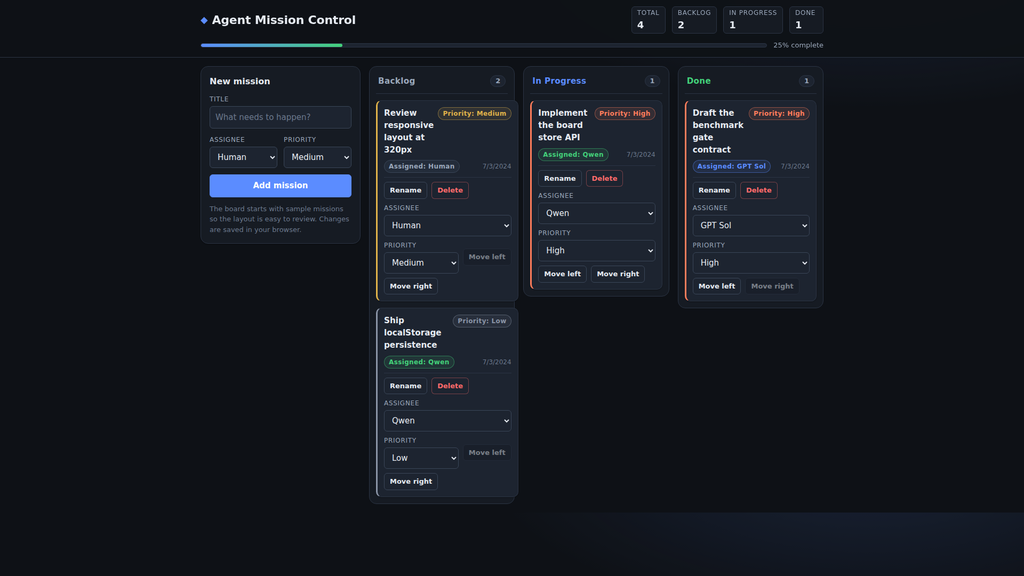
こちらはQwenが実装したものです。同じ仕様と受け入れ条件を渡していますが、見た目や情報の配置にはモデルごとの違いが出ました。
1回ずつの有効な成功例では、以下の結果になりました。
GPT Solが直接実装
・実装時間: 148.2秒
・親の非キャッシュ入力+出力: 27,703トークン
・テスト、画面確認: 合格

Qwenへ委譲
・子の実装時間: 540.8秒
・親の非キャッシュ入力+出力: 16,249トークン
・直接実装に対する削減率: 41.3%
・テスト、画面確認: 合格
完成品質は、今回用意した受け入れ条件では同等でした。親となるGPT Solの非キャッシュ入力と出力は41.3%減った一方、Qwenの実装時間は約3.65倍になりました。
また、Qwen側でも大量のトークンを使っています(非キャッシュ入力+出力で42,389トークン)。こちらはローカルで動くためクラウドの利用枠は消費しませんが、処理時間と電気は必要です。今回は各方式を3回成功させた中央値ではなく、それぞれ1回の成功例です。Qwenが実装を始める直前に終了してしまう試行もあり、結果のばらつきも大きい状態でした。
現時点で言えるのは、「完成品質を保ったまま、ローカルLLMの活用で指示役モデルのトークンを4割くらい減らせる可能性はある。ただし時間はかかる」くらいでしょうか。
まとめ
GPT Solを上司、Qwenを部下にしたマルチエージェント構成で、クラウド側のトークンを節約できるか試した話でした。今回の単発比較では、完成品質を保ちながら親の非キャッシュ入力と出力を41.3%減らせました。その代わり、実装には約3.65倍の時間がかかっています。
今回やってみて、マルチエージェントによるAI活用は、組織設計に近いと感じました。高性能なAIを何に使うのか。ローカルLLMへどこまで任せるのか。完成とはどの状態なのか。失敗したときは誰が直すのか。ここの設計が難しいのが、なんというか人間っぽいですね。
